核心结论:Pavo 把 AI 短剧最烧钱的「抽卡成本」打到了 0 元——背后跑的是免费可商用的 Agnes Video 2.5 Flash。但真正让它变得能用的,不是模型本身,而是它把 Agent 工作流和剧集 工作流直接做成了产品体验。
本文整理自公众号「贾克斯的平行世界」《做AI短剧也免费了?AI视频最烧钱的一步被Pavo打到了0元》一文,对其中的实测环节与工作流拆解做精简提炼,并补充我们自己的解读。文末附原文链接。
产品速览:Pavo 是什么
先看一眼 Pavo 平台长什么样。它把多种创作模式收在了同一个输入框下方:
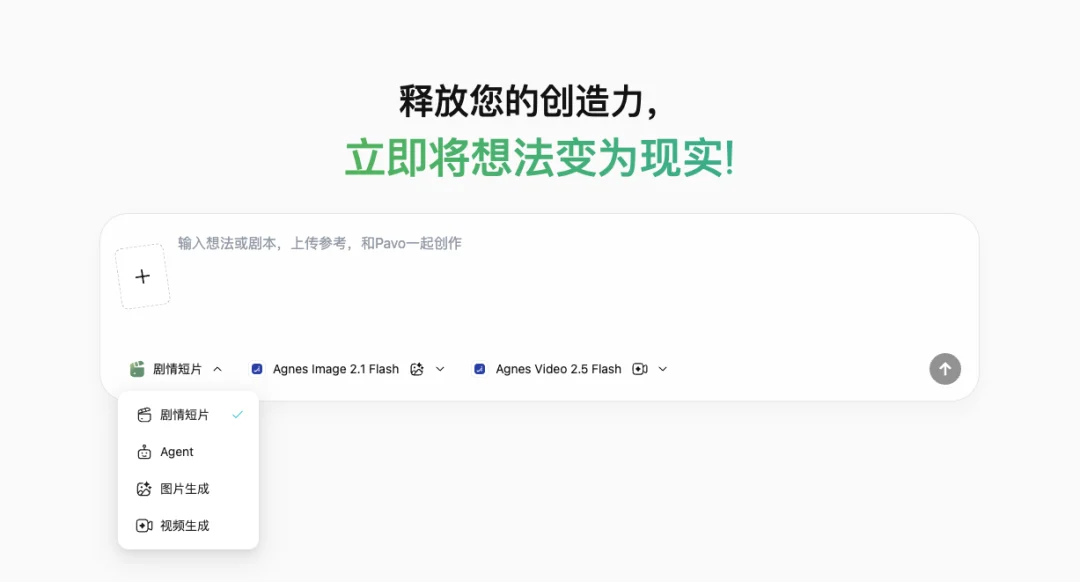 输入框 + 四种模式(剧情短片/Agent/图片生成/视频生成)+ Agnes Image 2.1 Flash / Agnes Video 2.5 Flash 双模型切换
顶部的输入框可以直接粘贴想法或剧本,下方四个入口分别对应四种工作流——这也是后文会用到的:剧情短片对应「二、完整短剧」、Agent对应「三、Agent 模式」。两个 Agnes 模型在右上随时可换,对免费用户也开放。点 app.pavo-ai.cn 直接用。
一、先试模型能力
从最基础的 10 秒左右视频生成开始,先用一个非常简单的提示词检验模型:
电影级东方武侠女性角色设定,25 岁左右的东亚女性,清冷克制的气质,黑色长发简单束起,几缕湿润碎发贴在脸侧,穿极简黑色窄袖古装,暗红色腰带,没有复杂刺绣,没有夸张首饰,仅有一枚简洁银色发簪。五官自然真实,眼神冷静坚定。暴雨夜环境,皮肤和头发带轻微湿润质感。中国电影摄影,高级电影感,真实人物质感,低饱和色彩,暗部丰富,柔和轮廓光,50mm 电影镜头,浅景深,16:9。
可以看到,人物面部的细节保留得不错——皮肤、眼睛、头发都没有明显的「塑料 AI 感」,双眼皮和湿发这种小细节也能看出来。从提示词还原度来看,「东方武侠、克制、低饱和、暴雨夜」几个关键词基本都落下来了。
▶ 效果视频 1:首镜头人物测试
接下来深化提示词,试试场景呈现能力:
保持参考人物的脸型、发型、黑色服装和暗红腰带设定,保持参考古庙的建筑、美术风格和红灯笼环境。一名黑衣年轻女性独自走在暴雨中的废弃古庙长廊,人物位于画面中远景,侧后方视角,湿润青石地面倒映暗红灯笼,雨水从屋檐大量落下,远处薄雾弥漫。电影宽画幅构图,东方志怪电影,青黑冷色环境,暗红色灯笼,真实电影光影,35mm 镜头。
这张主要验证三件事:人物有没有跑偏、环境有没有按上一张继续、整体美术风格能不能接得上。从结果看,这三个维度基本都守住了。不是说它已经强到可以无脑当最终成片,但作为一个免费、可以高频反复抽卡的模型,这个完成度已经相当够用了。
▶ 效果视频 2:场景延续测试:古庙暴雨
但做短剧,单条画面好看其实只是最容易的一关。真正难的是:它能不能把角色、场景、故事、镜头和修改串起来。所以接下来才是重点。
二、用 Pavo 做完整短剧《凌晨 2:17》
直接上了故事短片来测试。原因很简单——现在大部分 AI 视频模型的基本单位依然是一条几秒到十几秒的视频。即使模型能力已经很强,想用一条 Prompt 塞进去一段完整故事,基本等于让它在十几秒里同时处理人物、场景、叙事、表演、镜头和台词。信息一多,事情就开始失控。
所以现在比较主流的解决方案,是在视频模型外面再套一层 Agent:先理解故事,再拆任务、拆场景、拆镜头,最后逐个生成并合成。这也是为什么到了今天,一个 AI 视频平台好不好用,已经不能只看它接了什么模型——工作流本身,正在变得和模型一样重要。
2.1 第一步:需求确认(把自然语言变成制作Brief)
作者给了一段完整的短剧 Prompt:
请帮我制作一部完整的 40 秒左右电影感剧情短片,片名叫《凌晨 2:17》。故事发生在现代城市的一个深夜雨天。女主是一位 25 岁左右的中国女性,黑发齐肩齐刘海,清冷自然刘海,五官清秀真实,不是网红脸,淡妆,略显疲惫但气质安静克制。她穿深灰色宽松连帽卫衣,外搭米白色轻薄风衣,深色直筒长裤,白色运动鞋。全片必须保持女主的脸型、五官、发型、年龄、服装和整体气质高度一致,不要在不同镜头中改变人物长相和穿着。短片整体风格为现实主义都市…
如果直接把这段 Prompt 扔进一个视频模型,它需要在十几秒里同时理解情感短片、雨夜场景、故事要素和台词。所有东西挤在一起,最后大概率谁也不知道自己在忙什么。
Pavo 没有急着生成视频。它先给了一个「需求确认单」——把作者的自然语言整理成了一份更像「制作 Brief」的东西:
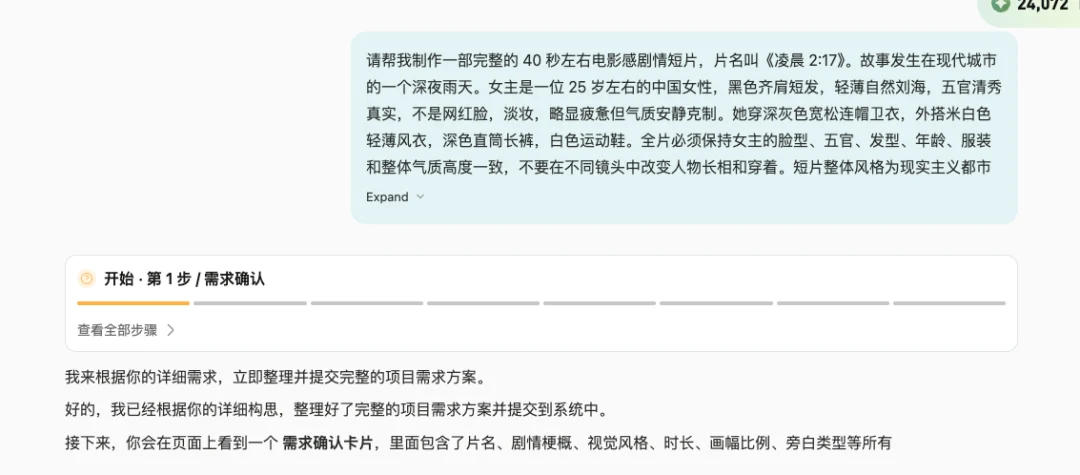 原文输入:凌晨 2:17 完整剧本
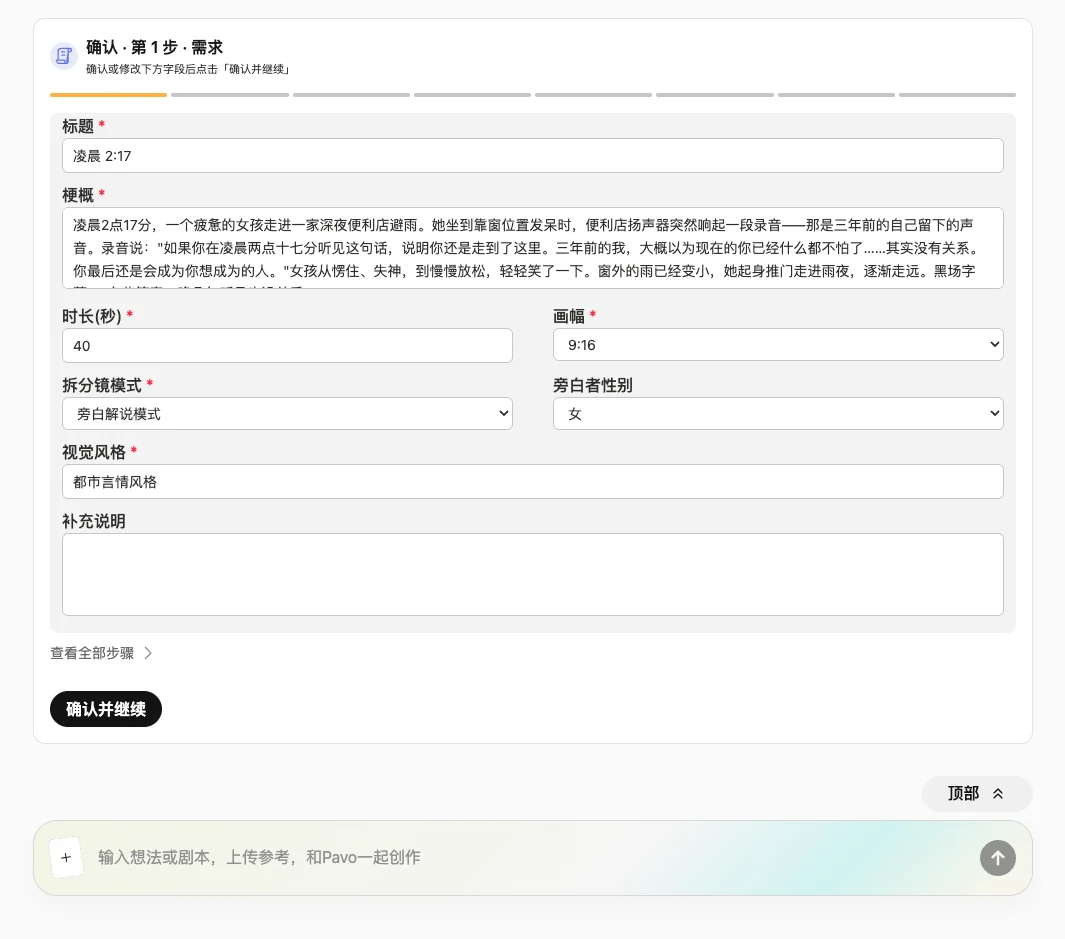 需求确认表单:标题/梗概/时长 40 秒/画幅 9:16/旁白解说模式/都市言情风格
这个步骤看起来不性感,但其实非常重要。很多 AI 视频翻车,并不是模型不行,而是模型压根没把你的需求理解成一个「可执行的制作任务」。
2.2 第二步:角色、场景、道具设计
确认方向以后,Pavo 继续往下做:先设计人物,再设计场景,再补核心道具,然后把这些设定分别生成对应的视觉资产。
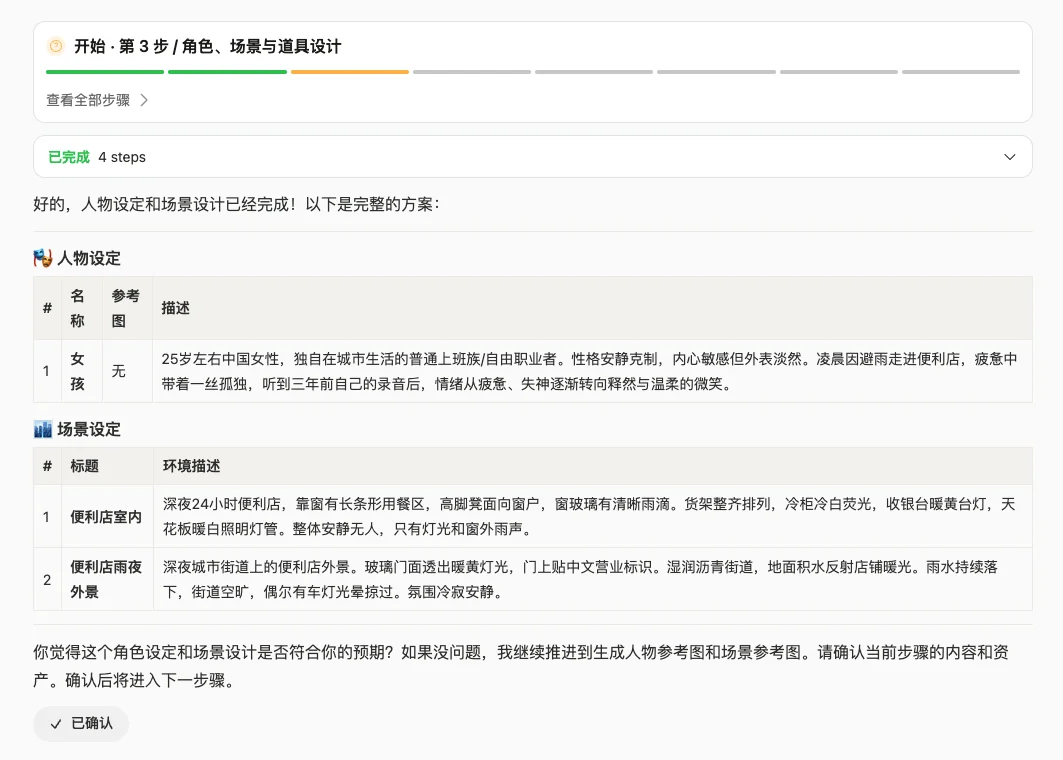 第 3 步:人物/场景/道具设计表
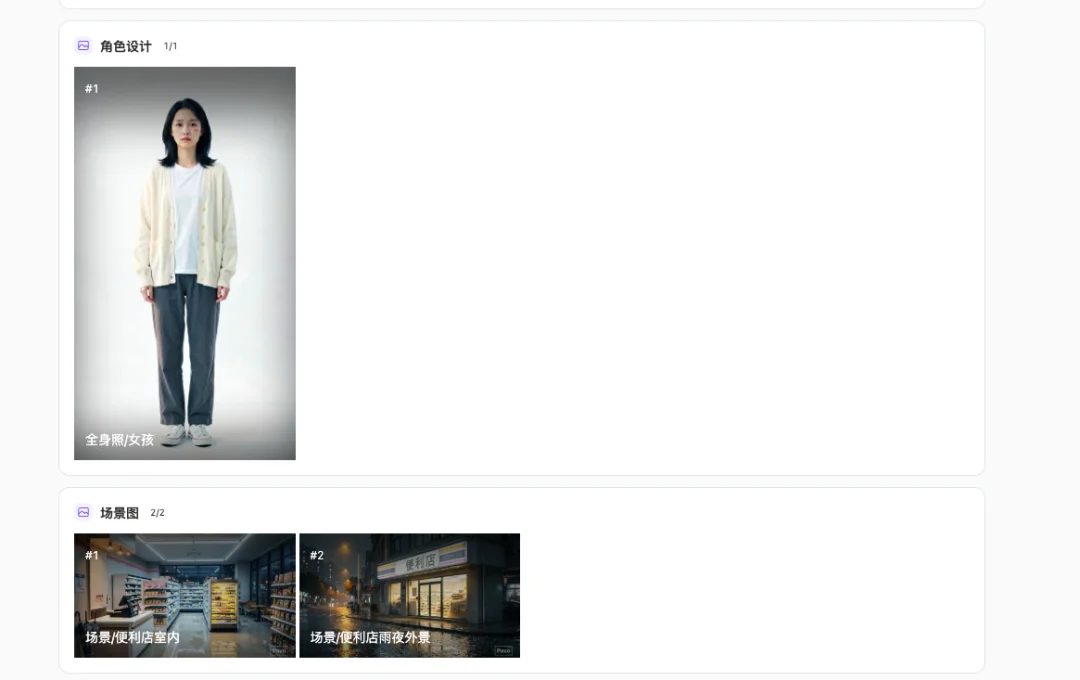 角色图 + 场景参考图
到了这里,其实已经有点像一个极简版本的 AI 剧组了——前面先定人物和美术,后面再按这些资产去拆镜头,而不是每生成一个镜头就重新「猜一次」角色长什么样。
▶ 效果视频 3:《凌晨 2:17》完整成片
三、Agent 模式:创作 Y Y D S
接下来上 Agent 模式——这是整个 Pavo 里作者最喜欢的一部分。这个 Agent 基于 Agnes 内置的 Harness 框架运行:
你负责告诉它「我要什么」,它负责思考「这件事应该分几步、调用哪些工具、先做什么后做什么」。
作者只给了它一段包含故事大纲的提示词——《今天开始,我不装了》,女主林晚 28 岁,在大型科技公司做基层经理,平时穿简单白衬衫和黑色西装裤,节俭、不爱花钱,因此经常被同事误会冷漠和吝啬。
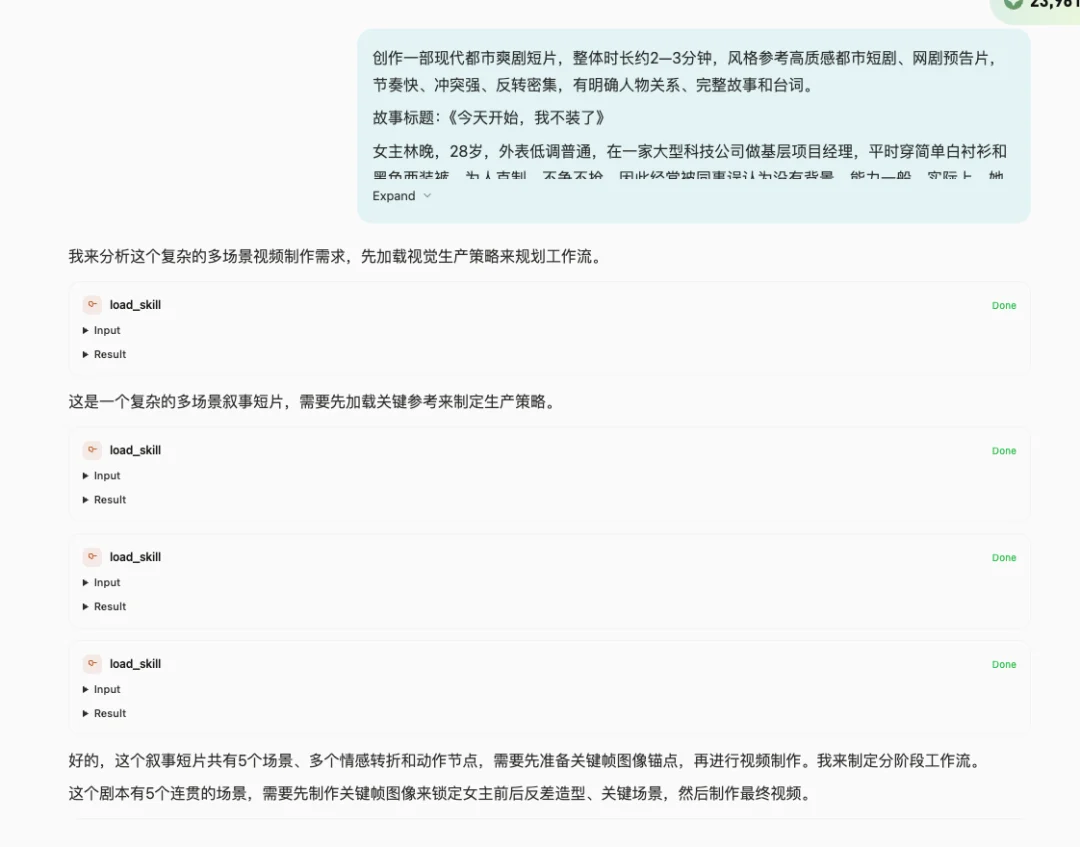 Agent 模式输入与 Skill 调用链
可以看到,Agent 会先分析需求和故事结构,然后不断调用不同 Skill,去完善角色、场景和分镜。最明显的区别是:你不需要自己像传统工作流那样,在文生图、图生视频、提示词工具和剪辑工具之间来回倒腾。
在它自动跑完多个 Skill 之后,作者拿到了下面这一组分镜图——而且从人物、色调到镜头语言,整体的一致性比预期更好。
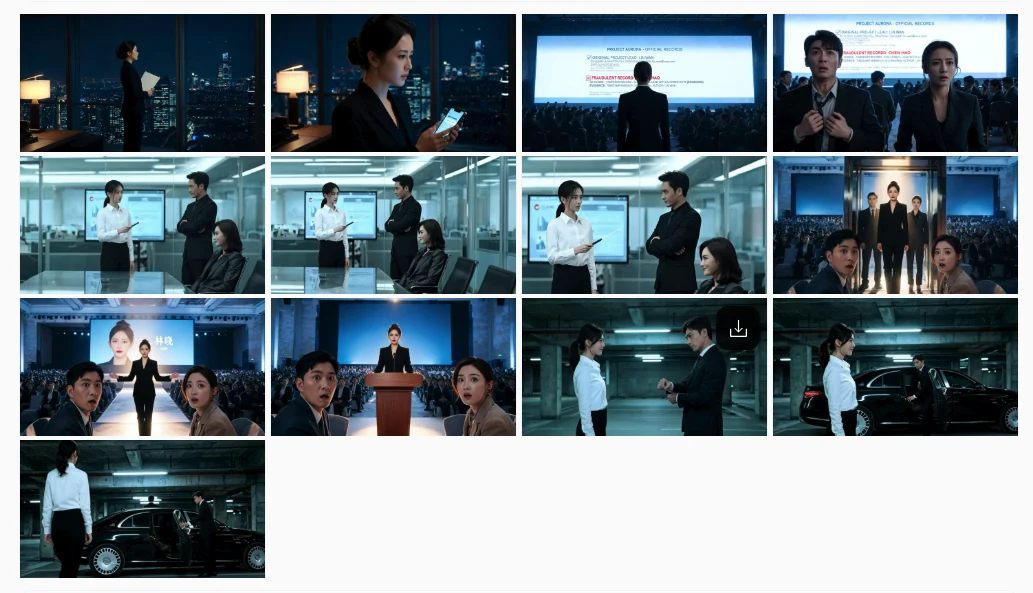 Agent 自动生成的分镜图(13 张)
确认以后继续往下生成,最后一条接近 3 分钟的短剧出炉。它当然不是一支可以直接拿去参加戛纳电影节的片子,但它也不再是一段人物站着不动、镜头绕一圈的模型 Demo——它是一条有开头、有转折、有产品、有笑点的完整内容。
▶ 效果视频 4:Agent 模式产出:《今天开始,我不装了》分镜
四、剧集模式:从「一条」到「整季」
Pavo 还专门针对短剧创作者推出了短剧模式。用一句话说清楚它在干什么——
以前你是一条一条做视频,现在你可以从「整部剧」开始做。
先把整个剧集的故事和剧本放进去;再根据自己的需求调整人物、世界观、场景和剧情;之后由系统继续拆集、拆镜头、生成资产。最终交付的单位,不再只是一条 4 秒、8 秒、12 秒的视频,而可以是一整组连续剧集。
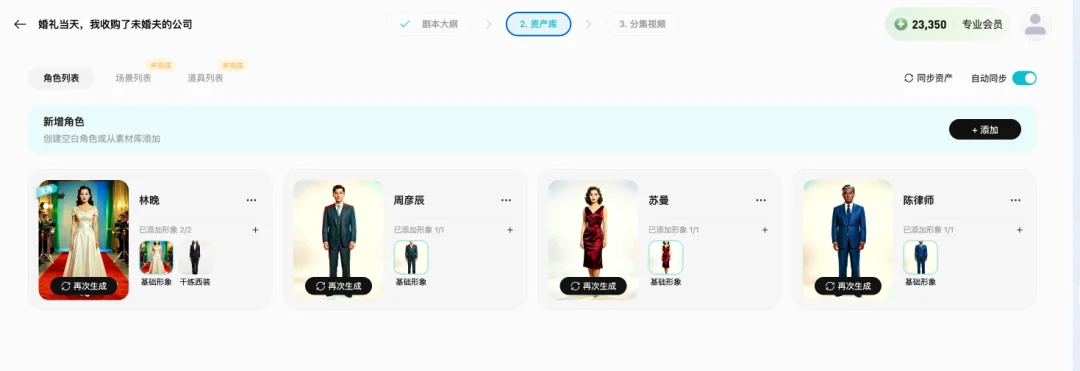 剧集模式:资产库 – 角色列表
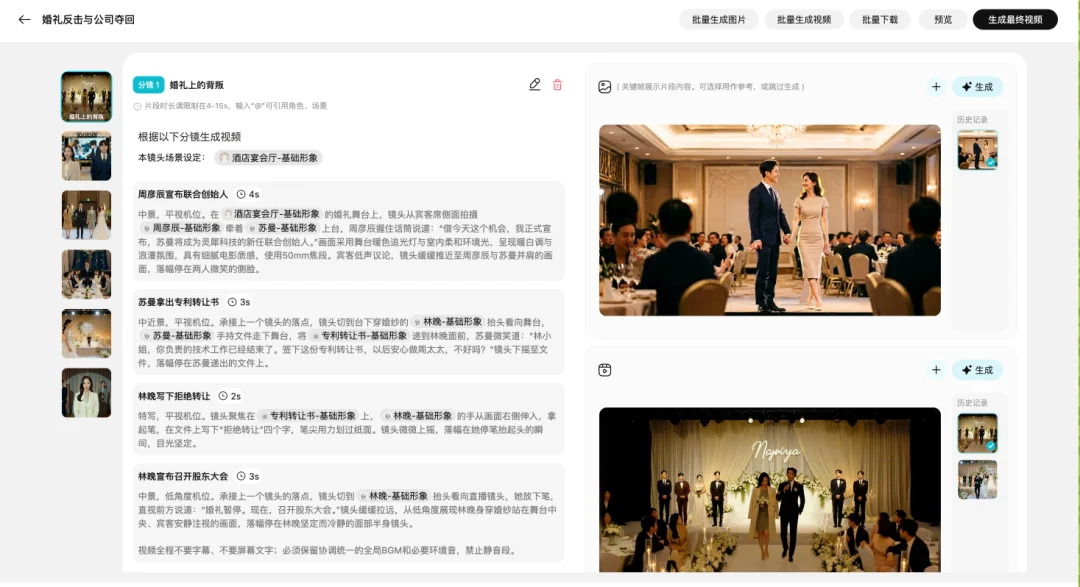 剧集模式:分镜表 + 镜头预览
▶ 效果视频 5:剧集模式产出:《婚礼当天》分镜
写在最后:Pavo 在解决哪一种成本
跑完前面几个 case,越来越能理解为什么 Pavo 这次会把「免费」放到这么重要的位置——因为 AI 视频真正烧钱的地方,很多时候不是最后那条成片,而是「抽卡成本」。
一个两三分钟的短剧,最后真正留下来的镜头可能没多少,但背后跑掉的视频往往是成片的好几倍。如果每一次尝试都按商业 API 计费,创作者很容易片子还没做出来,账单先跑出来了。
回头再看,Pavo 和 Agnes-Video-2.5 做的是两件完全不同、却刚好能接在一起的事:
- Agnes-Video-2.5-Flash 把一次次生成的成本压低,让创作者敢试更多动作、更多构图和更多表演。
- Pavo 把这些尝试留在同一个项目里,让人物、场景、分镜和修改意见可以继续往下传,不会每生成一次就散落一次。
一个降低钱的成本,一个降低混乱的成本。这才是「免费 AI 视频」真正进入短剧生产的关键。
「多试一次」的成本被打下来,创作者真的会开始疯狂尝试。而当尝试足够多,AI 视频的竞争逻辑也会随之改变——过去大家比的是,谁能生成一条更惊艳的 Demo;接下来更重要的可能是:谁能让创作者用更低的成本,稳定做出第 10 条、第 100 条,甚至第一整季。
所以,Pavo 是不是画质层面最强的视频工具?暂时不会这么下结论。但如果你问:它是不是现阶段最适合拿来大量试错、跑短剧工作流的 Seedance 2.5 平替之一?答案是:是。
参考资料
 Master